top bar

글 목록

레이블이 performance인 게시물을 표시합니다. 모든 게시물 표시

2016년 2월 12일 금요일

[Performance] The Grinder 3 (3) - 테스트 수행 및 리포트 산출

샘플 스크립트 작성


아주 간단한 HTTP Get 요청을 수행하는 스크립트를 작성해 본다.
그라인더 설치 디렉토리의 'example' 밑에 있는 스크립트를 참고하여 작성해보았다
import string
import random

from java.lang import String
from java.net import URLEncoder
from net.grinder.script import Test
from net.grinder.plugin.http import HTTPRequest
from net.grinder.common import GrinderException
from net.grinder.script.Grinder import grinder

# Server Properties
SERVER = "http://10.113.182.195:9001"
URI = "/test.jsp"

test = Test(1, "http_test")

class TestRunner:
    def __call__(self):
        request = HTTPRequest()
        requestString = "%s%s" % (SERVER, URI)
        test.record(request)
        result = request.GET(requestString)
        
        print "# Response text :", result.text
이전 포스트에서 언급했지만 그라인더는 'Jython' 스크립트를 사용해 부하 테스트를 수행 한다. 위의 코드는 HTTP Get 요청을 수행하는 간단한 스크립트이다.

위 파일을 'simplehttp.py' 라는 이름으로 저장하고, 'D:\grinder\python_source\grinder' 경로에 두었다. 따라서 'grinder.properties' 파일의 'grinder.script' 값을 아래와 같이 수정한다.
grinder.script = d:/grinder/python_source/grinder/simplehttp.py


테스트 수행


테스트하기 전, 프로세스와 스레드, 실행 횟수도 알맞게 설정해보자.
grinder.processes = 1
grinder.threads = 10
grinder.runs = 100
Agent 프로세스는 1개, 그 안에서 돌아가는 스레드를 50개로 설정 하였고, 각 스레드의 실행횟수는 100번으로 설정 하였다.

그리고 아래의 'start collecting' 버튼을 클릭한다.


그러면 'Collection stopped' 라는 메시지가 'Wating for samples' 라고 바뀔 것이다. 이제 Worker Agent로부터 샘플 데이터를 기다리는 상태가 된것이다.

이제 아래의 'Start the Worker processes' 버튼을 클릭하여 Worker Agent를 구동시킨다.


해당 버튼을 클릭하면 Agent 에 아래와 같은 로그가 찍힌다.


grinder.processes 값이 2이기때문에 2개의 Worker 프로세스가 시작된다. 특별히 정해진 네이밍 규칙이 있는데 '[host이름]-[seq번호]' 와 같은 식이다.

Agent 가 실행되면 'grinder.properties'파일의 grinder.consoleHost 와, grinder.consolePort 에 설정한(default는 localhost, 6372 이다) 호스트와 포트를 통해 수집된 데이터를 콘솔로 보낸다.

이때 Console창의 'Results' 탭을 보면 아래와 같이 수집되고 있는 데이터가 실시간으로 변화하는 모습을 볼 수 있다.


TPS, Mean Time 등의 용어들은 알아서 찾아보자! (이것도 시간나면 정리해야겠다)


GrinderAnalyzer를 이용한 리포트 산출


테스트를 완료하면 그라인더 'log' 디렉토리에 아래와 같은 로그가 쌓인다.


위 사진을 보면, 'host-n.log' 의 형식으로 생성되는 각 프로세스별 정보 로그 파일과, 'host-n-data.log' 형식으로 생성되는 각 테스트 건별 데이터 로그 파일이 보인다.

파일을 열어보면 알겠지만 건당 수행 결과와 측정 요소들의 값들이 로그로 잔뜩 찍혀 있는 것을 볼 수 있다. 이것은 두말 할 것 없이 한 눈에 보기가 불가능하다.

하지만 'GrinderAnalyzer' 라는 툴을 사용하면 위의 정보들을 종합하여
보기좋게 결과 리포트를 생성해준다.

아래에서 다운 받는다

http://track.sourceforge.net/analyzer.html

다운 받은 파일을 압축 해제 하면 아래와 같은 구조가 보일 것이다.


일단 윈도우 커맨드 창을 이용해 위의 'analyzer.py' 파일이 있는
디렉토리까지 이동한다.

그리고 아래와 같은 명령어를 입력 해보자.
(물론 jython home 경로가 윈도우 환경변수의 'path' 에 추가되어 있어야 한다.)
> jython analyzer.py "D:\grinder\grinder-3.11\log\hong-0-data.log D:
\grinder\grinder-3.11\log\hong-1-data.log" D:\grinder\grinder-3.11\log\hong-1.log 1
'jython analyzer.py' 다음에 쌍따옴표안에는 각 data log 파일의 '절대경로' 목록을 스페이스로 구분하여 입력한다. 그 다음에는 마지막 프로세스의 로그 파일인 'hong-1.log' 파일의 절대 경로를 입력한다.

마지막 파라미터로 주어지는 값은 몇개의 머신에서 Agent를 실행 시켰는지에 대한 값인데, 하나의 로컬 PC에서 Agent를 구동 하였으므로 '1'을 입력한다

위 명령어를 실행하면 아래와 같이 콘솔창에 로그가 찍힐 것이다.


그러고 나면 'grinderReport' 라는 폴더가 생성되어 있을 것이다.


해당 폴더안에 'report.html' 파일을 브라우저로 열어보자.
아래와 같이 테스트 수행 결과가 보기좋게 그래프와 표로 정리되어 나타난다.


마치며...


이것으로 그라인더 설치, 설정, 테스트 수행, 결과 리포트 산출까지 모든 정리를 마쳤다.

이외에도 그라인더를 다양한 방법과 스크립트를 이용해 사용할 수 있지만, 차차 기회가 되면 정리해보도록 하겠다.

2016년 2월 2일 화요일

[Performance] The Grinder 3 (2) - 기본 원리 및 실행 환경 설정

기본 원리


그라인더는 크게 3가지 Process로 나뉜다


  • Worker Processes :
    Jython 으로 작성된 테스트 스크립트를 Interpret하고 테스트를 수행한다
    다수의 Worker 스레드가 병렬적으로 동시에 테스트를 수행하게 된다
  • Agent Process :
    Worker 스레드의 실행/중지를 수행한다
    Console로부터 전달 받은 테스트 스크립트를 캐싱한다
  • The Console :
    위 2가지의 프로세스들을 제어 한다
    스크립트 작성과 배포를 담당한다
    테스트 수행시, 그래프 및 현황을 보여준다


실행 환경 설정 (윈도우 기반)


1) setGrinderEnv.cmd

set GRINDERPATH=D:\grinder\grinder-3.11
set GRINDERPROPERTIES=D:\grinder\grinder-3.11\conf\grinder.properties
set CLASSPATH=%GRINDERPATH%\lib\grinder.jar
set JAVA_HOME=C:\dev_tools\Java\jdk1.7.0_65
PATH=%JAVA_HOME%\bin;%PATH%
그라인더 home 경로와 properties 파일경로, jdk 경로 등을 정의하는 스크립트이다.

2) startConsole.cmd

call D:\grinder\grinder-3.11\bin\setGrinderEnv.cmd
java -Dgrinder.console.consolePort=6372 -Dgrinder.console.consoleHost=localhost -Xms1024m -Xmx1024m -cp %CLASSPATH% net.grinder.Console 
Console을 구동하는 스크립트이다. call명령어를 이용해 setGrinderEnv에서 정의한 변수들을 활용한다. Agent와의 통신을 위해 console port와 host를 자바 옵션으로 준다. (아마 옵션으로 주지 않아도 default 설정으로 되어 있을 것이다)

3) startAgent.cmd

set GRINDERPATH=D:\grinder\grinder-3.11\bin
call D:\grinder\grinder-3.11\bin\setGrinderEnv.cmd
echo %CLASSPATH%
java -cp %CLASSPATH% net.grinder.Grinder -daemon 5 %GRINDERPROPERTIES%
Agent를 구동하는 스크립트이다. 구동시에 '-daemon 5' 라는 옵션을 주는데, Console으로부터 응답이 없다면(Console이 죽었다면) 5초 간격으로 재접속을 시도하라는 의미이다.

4) 디렉토리 추가 및 설정


위 3가지 스크립트를 생성하면, grinder 설치 폴더에 'bin' 폴더를 생성한뒤 3개 스크립트를 그쪽으로 몰아 넣는다. Agent 설정파일인 'grinder.properties' 는 최초 'examples' 폴더에 존재하는데, 이 파일 또한 grinder 설치 폴더에 'conf' 폴더를 만들어서 그쪽에 넣도록 하자.

그러면 아래와 같은 구조가 될 것이다.


grinder.properties


Agent의 설정은 grinder.properties 파일에 작성된다. 해당 properties 파일의 경로는 setGrinderEnv.cmd 스크립트에서 변수로 정의되고, startAgent.cmd 스크립트에서 그 경로를 사용한다.

grinder.properties 의 주요 설정은 아래와 같다
#
# Commonly used properties
#
# The file name of the script to run.
#
# Relative paths are evaluated from the directory containing the
# properties file. The default is "grinder.py".
grinder.script = d:/grinder/python_source/grinder/stress_test.py
 
# The number of worker processes each agent should start. The default
# is 1.
grinder.processes = 1
# The number of worker threads each worker process should start. The
# default is 1.
grinder.threads = 50
# The number of runs each worker process will perform. When using the
# console this is usually set to 0, meaning "run until the console
# sneds a stop or reset signal". The default is 1.
grinder.runs = 1000
# The IP address or host name that the agent and worker processes use
# to contact the console. The default is all the network interfaces
# of the local machine.
; grinder.consoleHost = consolehost
# The IP port that the agent and worker processes use to contact the
# console. Defaults to 6372.
; grinder.consolePort
grinder.script : 테스트 스크립트의 경로를 입력
grinder.processes : worker 프로세스의 갯수
grinder.threads : 하나의 worker 프로세스 안에서 실행되는 스레드 갯수
grinder.runs : 테스트 수행 횟수
grinder.consoleHost : 콘솔과의 TCP 통신을 위한 host
grinder.consolePort : 콘솔과의 TCP 통신을 위한 port


실행


1) Console 구동


먼저 윈도우 cmd 창에서 'startConsole.cmd'를 실행한다.


조금 기다리면 grinder 콘솔 창이 노출된다.


빨간색 박스 부분이 Agent를 제어하는 부분인데, 비활성화 되어있다.
아직 Agent를 구동하지 않았기 때문이다.

2) Agent 구동


startAgent.cmd 를 실행하여 Agent를 구동해 보자.


위 처럼 startAgent.cmd 를 실행하면 콘솔의 host:port 로 connect를 성공했다는 로그가 찍힌다. 그리고 다시 Console 창을 보자.


방금전 비활성화 되어있던 Agent 제어 버튼이 활성화 되었다.

첫번째 버튼은 Agent가 테스트를 시작/중지 할 수 있게 명령을 내리는 버튼이고,
두번째 버튼은 Agent를 reset 하는 버튼인데, 이때 Agent는 grinder.properties 의 속성들을 다시 읽어 들인다. 따라서 grinder.properties의 값을 바꿨을때 Agent를 굳이 재시작 하지 않아도 reset 버튼으로 변경된 grinder.properties의 값을 적용 시킬 수 있다.

3) script root directory 설정


빨간색 박스안에 있는 버튼을 이용해 배포될 테스트 스크립트의 저장 경로를 설정 할 수 있다. 해당 경로 밑의 모든 파일들이 worker 프로세스에 배포되므로, 리눅스 환경에서의 '/home' 이나 윈도우 환경에서의 'C:\' 와 같은 최상단 디렉토리를 설정하면 절대 안된다.

보통 grinder 설치 폴더의 'examples' 폴더로 설정하는 것이 일반적이다.


이제 기본적으로 테스트를 수행하기 위한 모든 설정은 끝이 났다.

다음 포스팅에서는 기본적인 http 테스트를 위한 Jython 스크립트 작성과,
테스트 수행, 그리고 'GrinderAnalyzer' 를 이용한 결과 리포트 산출 등을 정리하겠다.


2016년 1월 31일 일요일

[Performance] The Grinder 3 (1) - 개요 및 환경 세팅

개요


그라인더는 'Load Test Tool' 이다. Http 기반의 일반적인 웹서비스 뿐만 아니라, SOAP, REST 웹서비스 등 에 대한 로드 테스트를 할 수 있다. 주로 'Stress Test' 에 사용된다.

그라인더의 강력함은 Jython 스크립트 작성을 통해서 다양한 시나리오를 테스트 할 수 있다는 것이다. 아래 그라인더 공식 페이지의 'Script Gallery'에서 종류별로 스크립트 예제를 참고 할 수 있다.

http://grinder.sourceforge.net/g3/script-gallery.html

Jython은 말 그대로 JAVA + Python 의 합성어로, 좀 혼란스러울 수도있지만 파이썬에서 자바 라이브러리를 사용 할 수 있게 해준다. 자바와 파이썬에 대한 기본적인 지식만 있으면 위 Script Gallery의 예제들은 대략적으로 이해 할 수 있을 것이다.

솔직히 Grinder 기반의 툴은 네이버에서 개발한 'nGrinder'가 대표적이고, 은근히 많이 사용되는 것 같다. 하지만 nGrider는 초딩도 할 수 있다고(...) 하여, 괜한 자존심이 발동 했다.

앞으로 몇번의 포스팅을 통해서 Grinder의 설치 및 세팅과, 기본적인 http request 스크립트 작성, GrinderAnalyzer를 이용한 리포트 산출 등을 정리 하고자 한다.

환경 세팅


그라인더를 사용하기 위해서는 몇가지 환경 설정이 필요하다.
앞으로 모든 실습은 '윈도우' 기반으로 진행 하도록 하겠다.

아참.. 당연히 JAVA 는 설치되어 있어야 한다!

(1) Jython 설치


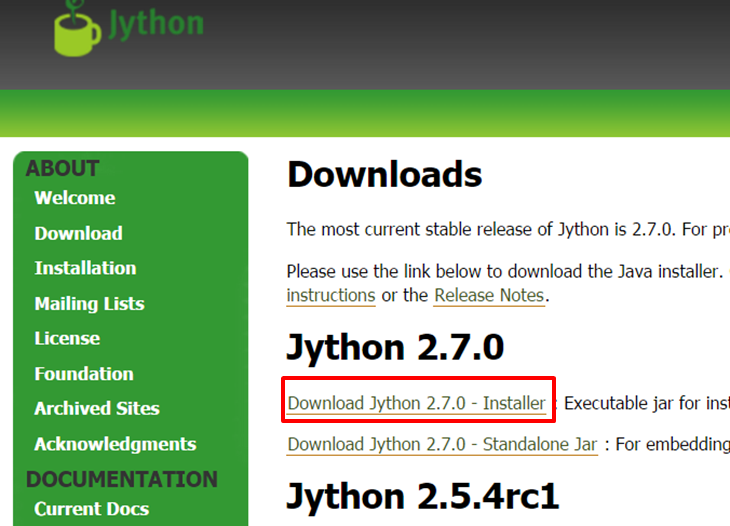
http://www.jython.org/downloads.html


자이썬 공식 사이트에 접속하여 Installer를 다운로드 한다. 이때 jar 파일이 다운로드 되는데 아래와 같은 명령어로 설치한다.
> java -jar jython_installer-2.7.0.jar
jar 파일을 구동하면 아래와 같은 install 창이 뜬다.


이후의 과정은 알아서...(?!)

(2) Grinder 다운로드 및 설치


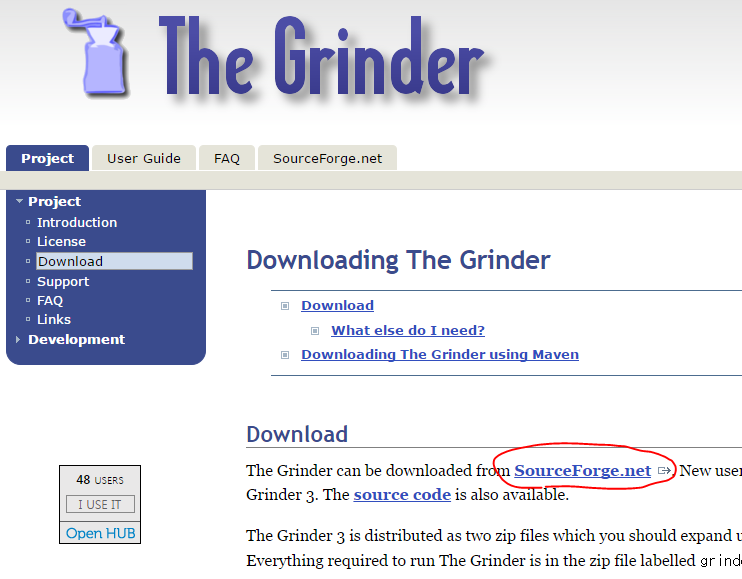
http://grinder.sourceforge.net/


SourceForge 링크로 따라가서 'zip' 파일을 다운로드한다.
다운로드한 파일을 압축 해제하면 아래와 같은 파일들이 보일 것이다.


그라인더는 기본적으로 자바기반이다. 앞으로 살펴볼 Agent, Worker, Console 등 그라인더의 주요 컴포넌트들도 자바로 구성되어 있다. 따라서 'lib' 디렉토리에는 이와 관련된 자바 라이브러리들이 한가득 들어차 있다.

'example' 디렉토리에는 공식 사이트에도 나와있는 예제 script들이 존재 한다. 이걸 참고해도 되지만 부가적인 설명이 있는 공식 사이트의 'Script Gallery' 를 참고 하도록 하자.

기본적인 실행환경 설정 등은 다음 포스팅으로 미뤄야 겠다.. To be continue...

2015년 10월 12일 월요일

[Performance] JVM Option을 활용한 heap dump 파일 추출. 'Eclipse Memory Analyzer' 로 분석하기

오늘은 자바 성능의 기본중의 기본, OOM에 대한 heap dump 파일을 떨구는 법과,
이를 Eclipse Memory Analyzer로 분석하는 방법을 포스팅하고자 한다.

1. 아래와 같은 코드를 작성
import java.util.ArrayList;
import java.util.List;

class HeavyInstance {
    char[] data = new char[10000000];
}

public class OOMTest {

    public static void main(String[] args) {

        List<HeavyInstance> dataList = new ArrayList<HeavyInstance>();

        while (true) {
            dataList.add(new HeavyInstance());
        }
    }
}
무조건 OutOfMemory 에러가 발생할 수밖에 없는 코드다.

2. 위 java application을 jar로 생성

Project > Export > Java > Runnable JAR file


Finish를 누르면 실행 가능한 jar 파일이 생성된다.

3. Jar 파일 실행

위 jar 파일을 실행하면 OOM이 발생하고, 아래와 같은 메시지와 함께 어플리케이션이 종료된다.
Exception in thread "main" java.lang.OutOfMemoryError: Java heap space
    at test.HeavyInstance.<init>(OOMTest.java:14)
    at test.OOMTest.main(OOMTest.java:30)
하지만 우리가 원하는 heap dump 파일을 생성하지는 못한다. 바로 아래와 같은 JVM 옵션을 주고 jar파일을 실행해야 heap dump 파일이 생성된다.
c:\> java -XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=c:\dumps -jar oom-test.jar
위 옵션을 주면, HeapDumPath 옵션에 지정한 경로로 아래와 같이 '.hprof' 확장자를 가진 dump 파일이 생성된다.


Confer.

jar파일을 생성하고 커맨드 라인에서 실행하기 귀찮다면, 아래 run configuration을 설정하여 JVM 옵션을 적용한 채로 이클립스에서 곧바로 실행 할 수 있다.


4. Eclipse Memory Analyzer(이하 mat)로 분석하기

mat는 무료이며, 아래에서 다운 받을 수 있다.

https://eclipse.org/mat/

heap dump 파일(.hprof) 을 이용해 momory leak 등 메모리 성능 이슈를 찾기에 용이한, 공짜치고는 훌륭한 툴인 것 같다.

mat를 실행하고 아래와 같이 방금전 추출한 dump 파일을 open한다


파일을 선택하면 3가지 옵션이 나오는데, 여기서는 Leak Suspects Report를 선택한다.
이는 자동적으로 dump 파일을 parsing하여 어떤 객체가 GC되지 않고 계속 살아있어 OOM의 원인이 되는지 분석해준다.


Finish 를 누르면 아래와 같은 화면이 노출 된다.


노란색 박스 아래쪽에 있는 'Details' 를 클릭하면, 생성된 instance의 갯수, 얼마나 heap 공간을 차지하는지 등, 상세한 정보가 나온다. 이를 통해 OOM의 원인을 분석할 수 있을 뿐만 아니라 잠재된 memory leak 이슈를 발견 할 수 있다.

5. 마치며..

'mat' 라는 툴은 앞에서도 말했지만 공짜치고는 상당히 디테일한 정보들을 제공 한다. 위의 예제에서는 아주 간단한 OOM 발생 어플리케이션의 예 였지만, 좀더 복잡한 자바 어플리케이션은 분석하기가 상당히 까다로울 것이다. 따라서 'mat' 툴에 대한 공부도 계속해서 해야 할것 같다....

2015년 9월 23일 수요일

[Performance] VisualVM + JMX 연동을 통한 tomcat cpu 사용량 모니터링

 지난 번에는 VisualVM과 Jstatd를 연동하여 remote jvm 을 모니터링하는 방법을 살펴보았다. 하지만 위 방법은 원격지 서버의 cpu 사용률까지 모니터링 하지는 못한다는 단점이 있었다.

이번 포스팅 에서는 'JMX'를 이용하여 원격지 jvm의 cpu사용량을 모니터링 해보도록 하겠다.

JMX란?


 JMX(Java Management Extensions)는 프로그래머들에게 자바 어플리케이션의 모니터링과 관리 기능을 제공한다. 실제로 이 API는 웹서버에서 네트워크 디바이스, 웹폰에 이르기까지 자바로 이용 가능한 것은 어느 것이든 로컬 혹은 원격으로 처리 할 수 있게 한다. JMX 기술은 JCP(Java Community Process)에 의해 개발된 밀접한 관계의 두 스펙, Java Specification Request (JSR) 3: Java Management Extensions (JMX) Specification 와 JSR 160: Java Management Extensions (JMX) Remote API 1.0에 의해 정의된다.


톰캣 구동 스크립트에 JVM 옵션 추가


매우 간단하다.

먼저 톰캣서버를 구동하기전에, bin/catalina.sh 쉘스크립트 파일에 아래와 같이 jvm 옵션을 추가해야 한다.
JAVA_OPTS="$JAVA_OPTS -Dcom.sun.management.jmxremote -Dcom.sun.management.jmxremote.authenticate=false -Dcom.sun.management.jmxremote.ssl=false -Dcom.sun.management.jmxremote.port=[port] -Djava.rmi.server.hostname=[ip address]
해당 옵션을 추가한후에 톰캣을 구동한다.


VisualVM 에서 모니터링하기


1) Remote > Add Remote Host...


입력창이 뜨면 원격지의 IP를 입력한다

2) Add JMX Connection


3) port 입력


jvm 옵션 추가시 입력했던 port를 입력한뒤 OK를 누르면 아래와 같이 생성된다


4) Sampler 탭에서 모니터링

이제 아래와 같이 원격지 tomcat 서버 전체의 cpu 사용량과 
각 클래스 및 메소드의 cpu사용량을 확인 할 수 있다!


2015년 8월 31일 월요일

[Performance] VisualVM + jstatd 연동을 통한 remote tomcat instance 모니터링

jstatd


 jstatd tool은 일종의 RMI server application이다. 원격지의 JVMs을 모니터링하거나, 원격지의 모니터링 툴이 로컬에 돌고있는 JVMs 에 접근할 수 있도록 해주는 인터페이스를 제공한다. 자세한 사항은 아래를 참고하자

http://docs.oracle.com/javase/7/docs/technotes/tools/share/jstatd.html


Steps


연동 절차는 의외로 간단하다.

1) 원격지의 tomcat이 구동되고있는 서버에서 jstatd를 실행한다
$ jstatd
하지만 다음과같은 에러가 떨어질 것이다.
Could not create remote object
access denied ("java.util.PropertyPermission" "java.rmi.server.ignoreSubClasses" "write")
java.security.AccessControlException: access denied ("java.util.PropertyPermission" "java.rmi.server.ignoreSubClasses" "write")
        at java.security.AccessControlContext.checkPermission(AccessControlContext.java:372)
        at java.security.AccessController.checkPermission(AccessController.java:559)
        at java.lang.SecurityManager.checkPermission(SecurityManager.java:549)
        at java.lang.System.setProperty(System.java:783)
        at sun.tools.jstatd.Jstatd.main(Jstatd.java:139)
따라서 'jstatd.all.policy' 라는 파일을 만들고 다음과 같은 내용을 입력한다
grant codebase "file:/home/asuraiv/apps/jdk/lib/tools.jar" {
        permission java.security.AllPermission;
};
해당 파일을 저장후 다시 아래와 같이 명령어를 입력하자.
$ jstatd -J-Djava.security.policy=/경로/jstatd.all.policy &

2) VisualVM 을 실행하여 Remote Host를 추가한다


위의 창에서 'Host name'을 해당 서버의 ip주소를 입력한후 'OK'를 누르면 아래와 같이 해당 서버에서 돌고있는 Java 인스턴스의 목록이 노출된다.


하지만 치명적인 단점이 있는데, 바로 cpu와 memory의 모니터링은 불가하다는 것이다.
이는 JMX를 사용함으로서 어느정도 극복할 수 있는데, 다음에 포스팅 해보겠다.


2015년 8월 27일 목요일

[MySQL] 실행계획 (Query Plan)

원문 - http://www.sitepoint.com/using-explain-to-write-better-mysql-queries/

개요


 MySQL 쿼리 옵티마이저는 쿼리를 실행할때 최적의 계획을 세운다. 그 계획을 Database용어로 '실행계획'(Query Plan)이라고 하는데, MySQL에서는 'EXPLAIN' 키워드를 이용해 실행계획에 대한 정보를 살펴 볼 수 있다.

 이는 이슈가 발생하는 문제의 쿼리를 이해하고, 어떻게 최적화 할지에대한 insight를 제공하는 매우 강력한 도구가 될 수 있는데, 불행하게도 이를 잘 사용하는 개발자는 별로 없는것 같다. (나 포함 ㅠ)


Understanding EXPLAIN's Output


'EXPLAIN' 을 사용하면 쿼리를 실행하기전에 실행계획을 분석하여 출력한다. 아래와 같은 예를 들어보자
EXPLAIN SELECT * FROM categories
********************** 1. row **********************
           id: 1
  select_type: SIMPLE
        table: categories
         type: ALL
possible_keys: NULL
          key: NULL
      key_len: NULL
          ref: NULL
         rows: 4
        Extra: 
1 row in set (0.00 sec)
이제부터 해당 항목들에대해 자세히 살펴보도록 한다


  • id : 쿼리 안에 있는 각 select 문에 대한 순차 식별자이다. 이순서대로 select문이 실행된다고 생각하면 된다.
  • select_type : select 문의 유형을 말한다. 각 유형은 아래와 같다
    • SIMPLE : 서브쿼리나 'union'이 없는 가장 단순한 select문을 말한다
    • PRIMARY : 가장 바깥에 있는 select 문을 말한다
    • DERIVED : form 문 안에있는 서브쿼리의 select 문이다.
    • SUBQUERY : 가장 바깥의 select 문에 있는 서브쿼리이다.
    • DEPENDENT SUBQUERY : 기본적으로 SUBQUERY와 같은 유형이며, 가장 바깥의 select문에 '의존성'을 가진 서브쿼리의 select문이다.
    • UNCACHEABLE SUBQUERY
    • UNION : union 문의 두번째 select 문을 말한다
    • DEPENDENT UNION : 바깥 쿼리에 의존성을 가진 union문의 두번째 select문을 말한다
  • table : 참조되는 테이블을 말한다
  • type : MySQL이 어떤식으로 테이블들을 조인하는지를 나타내는 항목이다. 이는 매우 중요한데, 이유는 이 타입을 분석함으로써 어떤 인덱스가 사용되고 사용되지 않았는지를 알 수 있고, 이를통해 어떤식으로 쿼리가 튜닝되어야하는지에 대한 insight를 제공하기 때문이다. 각 유형은 아래와 같다
    • system : 0개 또는 하나의 row를 가진 테이블이다.
    • const 
    • eq_ref : primary key나 unique not null column으로 생성된 인덱스를 사용해 조인을 하는 경우이다. const 방식 다음으로 빠른 방법이다.
    • ref : 인덱스로 지정된 컬럼끼리의 '=' , '<=>' 와 같은 연산자를 통한 비교로 수행되는 조인이다
    • index_merge 
    • unique_subquery : 오직 하나의 결과만을 반환하는 'IN'이 포함된 서브쿼리의 경우이다.
    • index_subquery : unique_subquery와 비슷하지만 여러개의 결과를 반환한다
    • range : 특정한 범위의 rows들을 매칭시키는데 인덱스가 사용된 경우이다. BETWEEN이나 IN, '>', '>=' 등이 사용될 때이다.
    • all : 조인시에 모든 테이블의 모든 row를 스캔하는경우이다. 물론 성능이 가장 좋지 않다.
  • possible_keys : 테이블에서 row를 매핑시키기 위해 사용 가능한 (사용하지 않더라도) 키를 보여준다.  
  • key : 실제적으로 쿼리 실행에 사용된 key의 목록이다. 이 항목에는 possible_keys 목록에 나타지 않은 인덱스도 포함 될 수 있다.
  • ref : key column에 지정된 인덱스와 비교되는 column 또는 constants를 보여준다.
  • rows : 결과 산출에 있어서 접근되는 record의 숫자이다. 조인문이나 서브쿼리 최적화에 있어서 중요한 항목이다.
  • Extra : 실행계획에 있어서 부가적인 정보를 보여준다.
    • http://dev.mysql.com/doc/refman/5.6/en/explain-output.html#explain-extra-information

2015년 8월 3일 월요일

[Elasticsearch] document routing

1. 개요


Elasticsearch는 기본적으로 'shard' 라는 개념으로 구성되어 있다. 이 'shard'라는것은 저장공간을 논리적으로 나눈 단위이다. document가 색인될때, 이 shard에 저장되는데, 이때 내부적인 routing 동작을 통해 각 shard에 분산 저장된다. 즉 유입되는 document들이 각 shard로 퍼지는 것이다.

이런경우, search 동작시에 성능상의 이슈를 불러올 수 있다. 왜냐하면 document를 검색할때에 모든 shard를 다 뒤질 것이기 때문이다. shard의 갯수가 많다면, 그리고 각 shard의 크기가 크다면, 검색은 상당한 시간이 걸릴 것이다.


2. Route


Elasticsearch에서는 이러한 검색 성능 튜닝 방법중의 하나로 'routing'이라는 기능을 제공한다. 이 방식은 routing 기준이 되는 field를 정하고, 그 기준 field의 값에 따라서 하나의 shard로 document를 색인하는 것이다.


3. 예제를 통해 살펴보자


아주 생각하기 쉬운 예를 들어 보겠다. 누구나 학창시절, 학기 초 반배정의 두근두근함을 기억할 것이다. 내가 몇반이 되었을까, 내가 원하는 친구랑 같은 반일까 하는... 기억들 말이다. 뭐 이건 잡설이고..

학생 10명이 있다고 하자, 그중 5명은 'A' 반으로, 3명은 'B' 반으로 그리고 2명은 'C' 반으로 배정을 받았다. 새학기 등교 첫날, 학생들은 각자 배정받은 반의 교실로 입실하여 수업준비를 할 것이다.

이 간단한 예시에서 학생은 'document', 반은 routing 기준이 되는 field, 교실은 'shard'에 비유할 수 있을 것이다.

직접 예제를 수행해 보자.

일단 아래와 같은 bulk 데이터를 준비하자
{"index": {"_index": "school", "_type": "students", "_id": 1}}
{"class": "A", "name": "albert"}
{"index": {"_index": "school", "_type": "students", "_id": 2}}
{"class": "A", "name": "david"}
{"index": {"_index": "school", "_type": "students", "_id": 3}}
{"class": "A", "name": "brown"}
{"index": {"_index": "school", "_type": "students", "_id": 4}}
{"class": "A", "name": "jimmy"}
{"index": {"_index": "school", "_type": "students", "_id": 5}}
{"class": "A", "name": "jennifer"}
{"index": {"_index": "school", "_type": "students", "_id": 6}}
{"class": "B", "name": "hong"}
{"index": {"_index": "school", "_type": "students", "_id": 7}}
{"class": "B", "name": "kim"}
{"index": {"_index": "school", "_type": "students", "_id": 8}}
{"class": "B", "name": "john"}
{"index": {"_index": "school", "_type": "students", "_id": 9}}
{"class": "C", "name": "tomas"}
{"index": {"_index": "school", "_type": "students", "_id": 10}}
{"class": "C", "name": "jamie"}
10명의 학생들에대한 간단한 정보다. 위에 예를 들었던 대로 5명은 A, 3명은 B, 2명은 C 클래스로 배정을 했다.

이제 위의 bulk 데이터를 인덱싱할 인덱스를 만들어야 하겠다. 아래와 같이 인덱스를 생성하자.
$ curl -XPUT 'localhost:9200/school?pretty' -d '{
    "mappings": {
        "students": {
            "_routing": {
                "required": true,
                "path": "class"
            },
            "properties": {
                "class": {
                    "type": "string",
                    "index": "not_analyzed"
                },
                "name": {
                    "type": "string"
                }
            }
        }
    }
}'
주목해야 할 것은 바로 '_routing' 설정이다. required 와 path 두가지 설정을 가지는데, 여기서 'path' 설정에 들어가는 값이 routing 기준이 되는 field 인 것이다.

그 밑에 'properties' 로 각 필드에 대한 설정을 하는데, 여기서 중요한 것은 'path' 설정에 들어간 field의 store 속성은 반드시 'true'로 해야하고 index 속성은 'not_analyzed'로 해야 한다는 것이다. 위의 예시에서 store는 기본값이 true이므로 생략하였고, index 속성은 'not_analyzed'로 설정하였다.

이제 아래의 curl을 이용하여 bulk 데이터를 색인해 보자.
curl -XPUT 'localhost:9200/_bulk?pretty' --data-binary @data.json
참고로 @파일이름 와 같은 형식으로 bulk 데이터 파일을 지정한다. data.json파일은 위의 10명의 학생 정보에 대한 bulk 데이터 파일이다.

일단 아래와 같이 school indice에 10개의 shard가 있다고 가정하자.


기준값 (class) 별로 routing이 잘 되었을까? shard를 하나씩 클릭해봄으로 확인 할 수 있다.


각각 0번, 8번, 9번 shard에 2개, 5개, 3개의 document가 색인 된 것을 볼 수 있다.

조회는 아래와같이 _search api 사용시 query string으로 routing 파라메터를 주어 조회 할 수 있다.
$ curl -XGET 'localhost:9200/school/students/_search?pretty&routing=B'
{
  "took" : 1,
  "timed_out" : false,
  "_shards" : {
    "total" : 1,
    "successful" : 1,
    "failed" : 0
  },
  "hits" : {
    "total" : 3,
    "max_score" : 1.0,
    "hits" : [ {
      "_index" : "school",
      "_type" : "students",
      "_id" : "6",
      "_score" : 1.0,
      "_source":{"class": "B", "name": "hong"}
    }, {
      "_index" : "school",
      "_type" : "students",
      "_id" : "7",
      "_score" : 1.0,
      "_source":{"class": "B", "name": "kim"}
    }, {
      "_index" : "school",
      "_type" : "students",
      "_id" : "8",
      "_score" : 1.0,
      "_source":{"class": "B", "name": "john"}
    } ]
  }
}
routing파라메터 값을 'B'로 주었고, 그에따라 search api는 모든 shard를 검색하는것이 아니라 class : B 로 routing된 shard만 검색하여 결과를 보내준다.

이러한 routing을 통해서, 특정 데이터를 검색할때 성능을 향상 시킬 수 있는 것이다.